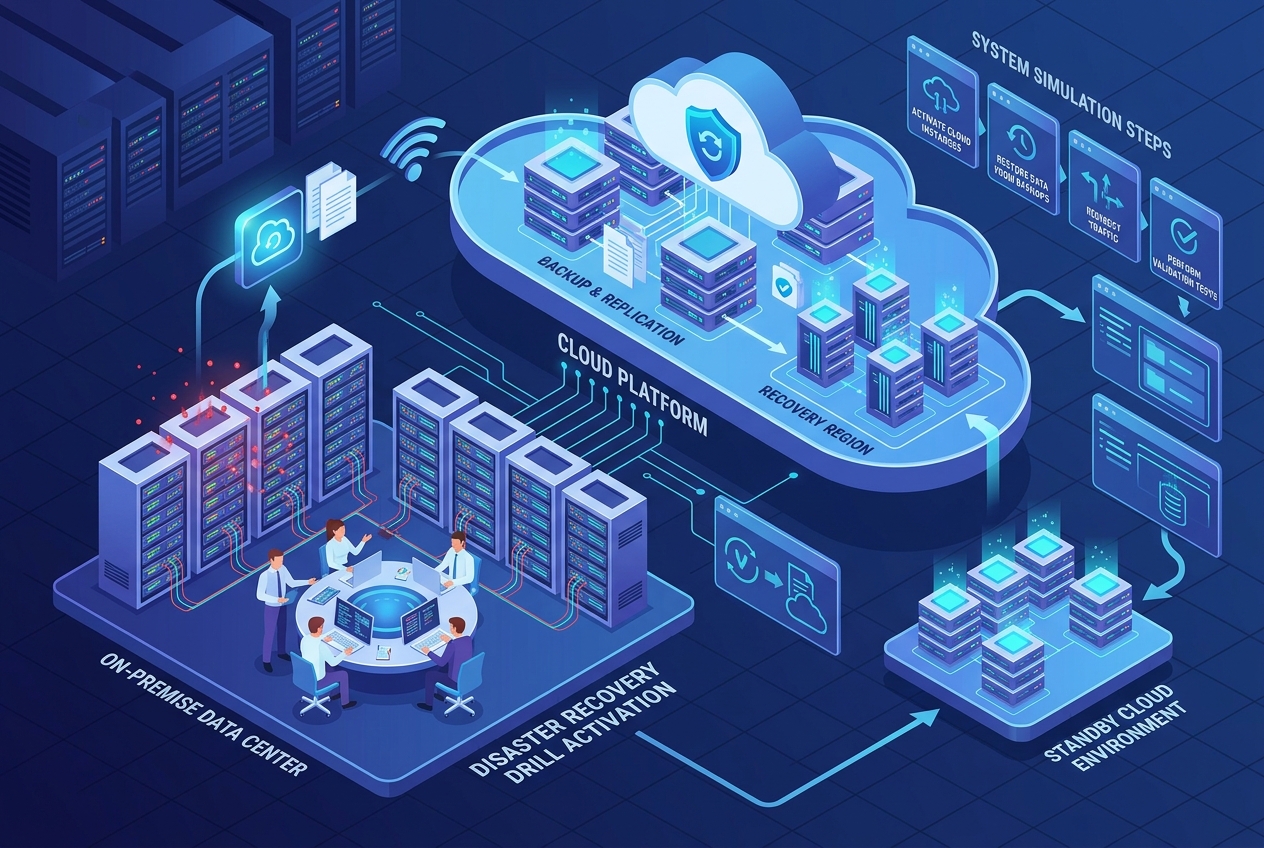
クラウド環境の普及により、企業のシステム基盤は柔軟性と拡張性を手に入れた一方で、障害発生時の対応手順はより複雑になっています。特に自然災害やサイバー攻撃、大規模障害などの不測の事態に備える「DR(Disaster Recovery:災害復旧)訓練」は、事業継続性を確保するうえで欠かせない取り組みです。
しかし、「DR訓練をどのように計画すればよいのか分からない」「クラウド特有の注意点が分からず不安」という声も少なくありません。オンプレミス環境とは異なり、クラウドではサービスプロバイダーとの責任分界点や、マルチリージョン構成といった独自の考慮点が存在します。
本記事では、DR訓練の手順をクラウド環境で計画・実施するための基本知識から、具体的な訓練の流れ、継続的な運用体制の構築方法まで、実務に役立つ形で詳しく解説します。これからDR訓練を導入する担当者の方も、既存の訓練プロセスを見直したい方も、ぜひ参考にしてください。
記事のポイント
- DR訓練がクラウド時代に必要とされる理由と背景を解説
- 目標復旧時間(RTO)と目標復旧地点(RPO)の設定方法を紹介
- シナリオ設計から評価・改善までの具体的な訓練手順を詳解
- 訓練を継続的に運用するための体制づくりのコツを紹介
DR訓練の手順をクラウドで計画する基本
DR訓練を成功させるためには、実施前の計画段階が非常に重要です。ここでは、クラウド環境でDR訓練を計画する際に押さえておくべき基本的な考え方について解説します。
DR訓練が必要とされる背景と目的
近年、地震や台風などの自然災害に加え、ランサムウェアをはじめとするサイバー攻撃の脅威が急速に高まっています。総務省が公開する情報通信白書でも、企業のBCP(事業継続計画)策定の重要性が繰り返し指摘されており、システム障害が発生した際にいかに早く事業を復旧できるかが企業の存続を左右する時代になっています。
DR訓練の主な目的は以下の通りです。
- 復旧手順の実効性を検証すること
- 担当者の対応スキルを向上させること
- 復旧計画書と実際のシステム構成の乖離を発見すること
- 経営層やステークホルダーへの説明責任を果たすこと
特にクラウド環境は日々アップデートされるため、半年前に策定した復旧手順が現在の構成と一致していないケースも珍しくありません。定期的な訓練を通じて、計画と実態のギャップを埋め続けることが重要です。
クラウド環境特有のリスクと課題
オンプレミス環境とクラウド環境では、DR対策で考慮すべきポイントが大きく異なります。クラウド特有のリスクとして、以下のような点が挙げられます。
責任共有モデルの理解不足
クラウドサービスでは、インフラ部分はクラウドベンダーが責任を持ち、その上で稼働するデータやアプリケーションの管理は利用者側の責任となる「責任共有モデル」が採用されています。例えばAWSの責任共有モデルのように、どこまでがベンダーの責任範囲で、どこからが自社の責任範囲なのかを正確に理解していないと、いざという時に「誰が何をすべきか」が曖昧になり、復旧対応が遅れる原因となります。
マルチリージョン・マルチクラウド構成の複雑さ
可用性を高めるために複数のリージョンやクラウドサービスを併用している場合、障害発生時の切り替え手順がより複雑になります。どのリージョンにフェイルオーバーするか、データの整合性はどう担保するかなど、事前に整理しておくべき事項が多岐にわたります。
コストとパフォーマンスのバランス
DR環境を常時稼働させる「ホットスタンバイ」方式はコストが高くなる一方、必要な時だけ構築する「パイロットライト」方式はコストを抑えられますが復旧に時間がかかります。自社の事業特性に合わせた方式選択も、クラウドならではの課題です。
訓練前に整理すべき体制と役割分担
DR訓練を実施する前に、まず社内の体制と役割分担を明確にしておく必要があります。以下のような役割を事前に定義しておきましょう。
- 訓練統括責任者:訓練全体の計画・進行を管理する
- インフラ担当者:クラウド環境の切り替え作業を実施する
- アプリケーション担当者:業務システムの動作確認を行う
- 広報・連絡担当者:関係者への状況共有や連絡を担う
- 記録・評価担当者:訓練の進捗と結果を記録する
特に注意したいのは、実際の災害時には担当者自身も被災者となる可能性があるという点です。特定の個人しか手順を把握していない「属人化」の状態は非常に危険です。訓練を通じて複数名が同じ手順を実行できるよう、ナレッジの共有を意識した体制づくりが求められます。
目標復旧時間と復旧地点の設定方法
DR対策を検討する上で欠かせない指標が、RTO(Recovery Time Objective:目標復旧時間)とRPO(Recovery Point Objective:目標復旧地点)です。
RTO(目標復旧時間)とは
RTOとは、災害発生からシステムが復旧するまでに許容できる時間を指します。例えば「RTO4時間」と設定した場合、障害発生から4時間以内にシステムを復旧させることが目標となります。ECサイトのように停止による機会損失が大きいシステムはRTOを短く設定する必要があり、その分コストも高くなる傾向にあります。
RPO(目標復旧地点)とは
RPOとは、災害発生時にどの時点までのデータを復旧できればよいかを示す指標です。「RPO1時間」であれば、障害発生の1時間前の状態までデータを戻せればよいという基準になります。バックアップの頻度を高めるほどRPOは短くなりますが、その分ストレージコストや処理負荷が増加します。
これらの指標は、経営層を交えたビジネスインパクト分析(BIA:Business Impact Analysis)を通じて、業務ごとの重要度に応じて個別に設定することが望ましいでしょう。すべてのシステムに同一の基準を適用するのではなく、優先順位をつけたメリハリのある設計が、コスト効率と実効性の両立につながります。
DR訓練の手順を実施する具体的な流れ
計画段階の準備が整ったら、いよいよ実際にDR訓練を実施していきます。ここからは、具体的な手順とチェックポイントを順を追って解説します。
シナリオ設計とテストケースの作り方
DR訓練の質を左右する最も重要な要素が、シナリオ設計です。現実に起こり得る障害を想定し、具体的なテストケースに落とし込んでいきます。
想定すべき障害シナリオの例
- 特定のアベイラビリティゾーン(AZ)の障害
- リージョン全体の大規模障害
- データベースの破損・消失
- ランサムウェアによるデータ暗号化
- 人為的な誤操作によるリソース削除
- ネットワーク回線の切断
これらのシナリオは、発生確率とビジネスへの影響度の両面から優先順位をつけ、段階的に訓練対象を広げていくのが効果的です。最初から複雑な複合障害を想定するのではなく、まずは単一障害からスタートし、徐々に難易度を上げていくアプローチをおすすめします。
テストケースに含めるべき要素
各シナリオに対して、以下の要素を盛り込んだテストケースを作成しましょう。
- 障害発生の検知方法
- エスカレーションのフロー
- 復旧作業の具体的な手順
- 復旧完了の判定基準
- 想定される所要時間
クラウドサービスを使った復旧環境の準備
クラウド環境の大きな利点は、必要な時に必要なだけリソースを構築できる柔軟性にあります。DR訓練においても、この特性を活かした準備が可能です。
バックアップとスナップショットの活用
多くのクラウドサービスでは、定期的なスナップショットやバックアップ機能が標準で提供されています。例えばMicrosoft Azure Backupのようなサービスを利用すれば、仮想マシンやデータベースの状態を定期的に保存し、訓練時にはそのバックアップから復旧環境を再現できます。
Infrastructure as Code(IaC)による環境再現
TerraformやAWS CloudFormationといったIaCツールを活用すれば、インフラ構成をコード化しておくことで、訓練のたびに同一条件の環境を迅速かつ正確に再構築できます。手作業による環境構築はミスが発生しやすく、訓練の再現性にも影響するため、可能な限り自動化しておくことが望ましいでしょう。
本番環境から隔離されたテスト環境の確保
訓練用の環境は、本番環境に影響を与えないよう完全に隔離されたネットワークやアカウント内に構築することが鉄則です。誤って本番データを操作してしまうといった事故を防ぐため、アクセス権限の管理も厳格に行いましょう。
訓練実施時のチェックポイント
実際に訓練を開始したら、以下のチェックポイントを意識しながら進行状況を確認していきます。
- 検知から初動対応までの時間は適切か
- 手順書通りに作業が進められるか、記載の不備はないか
- 担当者間のコミュニケーションは円滑か
- 復旧後のデータ整合性は保たれているか
- RTO・RPOの目標値を達成できているか
訓練中は、可能な限り実際の障害対応に近い緊張感を持たせることが重要です。事前に手順を暗記してしまっている状態でのなぞり作業ではなく、抜き打ちで実施したり、想定外の要素を一部盛り込んだりすることで、より実践的な検証が可能になります。
結果の記録と評価方法
訓練が終了したら、速やかに結果を記録し、客観的な評価を行います。記録すべき項目には以下のようなものがあります。
- 実際に要した復旧時間(実測RTO)
- データ損失の有無と範囲(実測RPO)
- 手順書との差異が発生した箇所
- 担当者から挙がった気づきや懸念点
- 予期しないトラブルの発生内容
評価にあたっては、単に「成功」「失敗」の二択で判断するのではなく、目標値に対する達成度合いを数値で可視化することが望ましいです。特に、初回の訓練では目標を達成できないケースが多いため、これを前提とした上で改善のプロセスに落とし込む姿勢が大切です。
課題抽出から改善計画への落とし込み
訓練で得られた記録をもとに、具体的な課題を抽出し、改善計画を策定します。このプロセスがDR訓練の中でも特に重要な部分です。
課題の分類方法
抽出された課題は、以下のようなカテゴリーに分類すると整理しやすくなります。
- 手順・ドキュメントの課題:手順書の記載漏れや古い情報
- 技術的な課題:ツールの不具合や設定ミス
- 体制・組織の課題:連絡体制の不備や権限設定の問題
- スキル・知識の課題:担当者の理解不足や経験不足
改善計画の策定と優先順位付け
抽出した課題に対しては、影響度と対応の難易度をもとに優先順位をつけ、次回訓練までに対応すべき項目を明確にします。改善計画には、担当者・期限・完了基準を明記し、進捗を定期的にフォローする仕組みを作ることが重要です。
改善が積み重なることで、訓練を重ねるごとに復旧時間が短縮され、組織全体のレジリエンスが着実に向上していきます。
定期的な訓練継続のための運用体制
DR訓練は一度実施して終わりではなく、継続的に実施することで初めて効果を発揮します。継続のためのポイントを解説します。
訓練頻度の設定
一般的には、年1〜2回の全社的な大規模訓練に加え、四半期ごとに部分的な訓練を実施する企業が多く見られます。クラウド環境は変化のスピードが速いため、システム構成に大きな変更があった際には、都度小規模な検証を行うことも推奨されます。
経営層の関与とコミットメント
DR訓練を形骸化させないためには、経営層の理解と関与が不可欠です。訓練結果を経営会議で報告し、必要な予算や人員の確保について継続的に議論する場を設けることで、組織としての優先度を維持できます。
外部の専門サービスの活用
自社だけでDR訓練の全プロセスを完結させることが難しい場合は、専門的な知見を持つ外部サービスの活用も有効な選択肢です。クラウド環境の監視や障害対応を24時間365日体制でサポートする運用支援サービスを利用することで、訓練の設計から実施、改善提案までを一貫して支援してもらうことができ、社内リソースが限られている企業にとって心強い味方となるでしょう。
ドキュメントの継続的なメンテナンス
訓練を重ねるたびに、手順書やチェックリストは最新の状態にアップデートしていく必要があります。バージョン管理システムを活用し、変更履歴を追跡できるようにしておくと、いつ・誰が・何を変更したのかが明確になり、監査対応にも役立ちます。
クラウドでのDR訓練手順まとめ
クラウド環境におけるDR訓練は、責任共有モデルの理解やマルチリージョン構成への対応など、オンプレミス環境とは異なる視点が求められます。RTO・RPOという明確な指標を設定した上で、シナリオ設計、環境準備、実施、評価、改善というサイクルを継続的に回していくことが、実効性のあるDR対策の実現につながります。
一度の訓練で完璧な体制を築くことは困難ですが、小さな改善を積み重ねていくことで、いざという時に組織全体が冷静かつ迅速に対応できる力が養われていきます。まずは自社のシステム構成を洗い出し、最初の一歩として簡易的な訓練シナリオの作成から着手してみてはいかがでしょうか。
記事のまとめ
- DR訓練はクラウド時代の事業継続に不可欠な取り組みである
- 責任共有モデルの理解が対応の遅れを防ぐ鍵となる
- RTOとRPOは業務の重要度に応じて個別に設定すべきである
- シナリオは単一障害から段階的に難易度を上げるとよい
- IaCを活用すれば訓練環境の再現性と効率を高められる
- 訓練結果は数値化して客観的に評価する必要がある
- 課題は分類した上で優先順位をつけて改善に落とし込む
- 経営層の関与が訓練の形骸化を防ぐ
- 外部の専門サービスの活用も有効な選択肢である
- 訓練は一度きりでなく継続的に実施することに価値がある